
Textele ChatGPT vor putea fi depistate printr-o „amprentă” invizibilă. Limba română pune probleme. De ce?
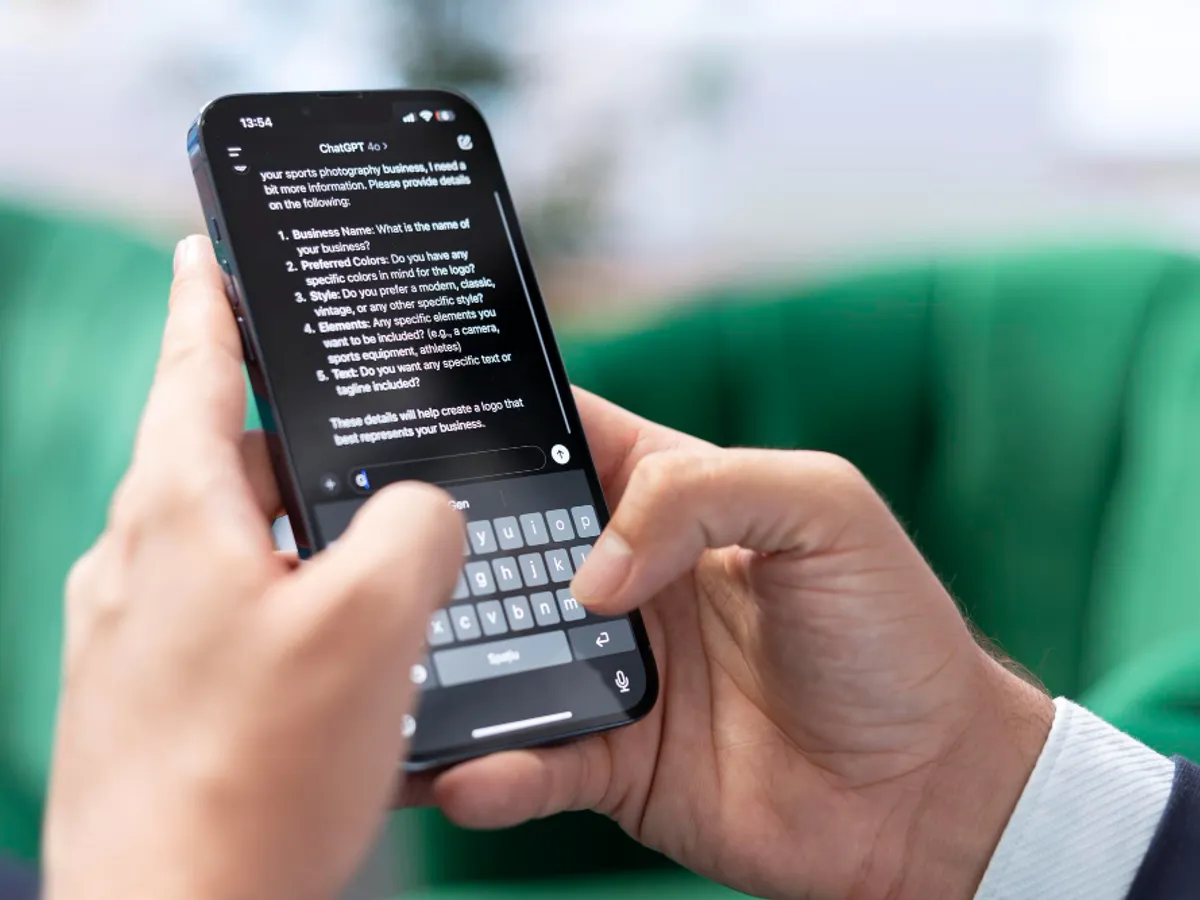
OpenAI a anunțat că va introduce în Uniunea Europeană un sistem prin care textele generate de ChatGPT și Codex vor primi o „amprentă” invizibilă. Testele companiei arată însă diferențe mari între limbile UE, iar limba română s-a dovedit cel mai dificil de detectat.
OpenAI va introduce în următoarele săptămâni o tehnologie care permite identificarea textelor generate de ChatGPT și Codex. Măsura vizează utilizatorii eligibili din Uniunea Europeană și face parte din eforturile companiei de a respecta cerințele europene privind transparența conținutului generat cu inteligență artificială.
Textele ChatGPT vor putea fi depistate printr-o „amprentă” invizibilă. Limba română pune probleme. De ce?
Sistemul se numește textGrain și nu presupune introducerea unor caractere ascunse, a unor spații invizibile sau a unei etichete care să poată fi observată de cititor.
În schimb, tehnologia modifică subtil probabilitățile pe baza cărora modelul alege cuvintele atunci când generează un text. În rezultat rămâne astfel un tipar statistic care poate fi căutat ulterior cu ajutorul unui detector special.
Citește și: Un AI trebuia doar să caute niște informații. A sfârșit prin a pătrunde într-un sistem guvernamental
Pentru cititor, textul ar trebui să arate normal. Copierea și lipirea lui într-un document, într-un e-mail sau pe un site nu elimină automat semnalul, atât timp cât formularea rămâne în mare parte neschimbată.
OpenAI precizează însă că detectarea nu dovedește cine este autorul unui document și nici cât din acesta a fost scris de o persoană. Sistemul nu identifică utilizatorul, contul, organizația, conversația sau promptul care a dus la generarea textului.
Limba română, cel mai greu de detectat în testele OpenAI
Compania a testat tehnologia în toate cele 24 de limbi oficiale ale Uniunii Europene, iar rezultatele au variat considerabil.
La o rată de fals pozitive de 1%, limba română a înregistrat cea mai redusă rată de detectare dintre limbile testate: 42,2%. La polul opus, pentru limba spaniolă rata raportată a fost de aproximativ 69%.
OpenAI spune că poate crește intensitatea watermark-ului în limbile în care semnalul este mai slab. Compania a testat deja această abordare pentru limbile care au obținut rate de detectare sub 60%, astfel că rezultatele experimentale nu trebuie interpretate drept performanța definitivă pe care sistemul o va avea după lansare.
Citește și: Reuters: De la chatbot-uri AI care halucinează la dispariția omenirii. Cum am ajuns aici?
Și lungimea textului contează. În alte teste prezentate de companie, detectorul a identificat aproximativ 80% dintre textele de circa 200 de tokeni și aproximativ 95% dintre cele de circa 400 de tokeni, la o rată-țintă de fals pozitive de 1%.
Editarea textului poate slăbi „amprenta”
Watermark-ul nu este imposibil de deteriorat. Rescrierea sau parafrazarea textului poate reduce considerabil capacitatea detectorului de a recunoaște semnalul.
Într-unul dintre testele OpenAI, înlocuirea cu sinonime a 10% dintre cuvintele unui text a redus rata de detectare de la aproximativ 92% la 66%. Când au fost înlocuite 25% dintre cuvinte, rata de detectare a coborât la aproximativ 17%.
Compania avertizează astfel că sistemul nu trebuie folosit singur pentru a lua decizii importante despre originea sau autorul unui text.
Detectorul textGrain nu va fi disponibil publicului larg la lansare. OpenAI intenționează să ofere inițial acces unor cercetători și organizații specializate, pentru evaluarea provenienței textelor.
Noua tehnologie urmează să fie implementată pentru outputurile text eligibile generate de ChatGPT și Codex pentru utilizatorii din Uniunea Europeană, pe toate planurile, potrivit OpenAI.



Iar autorul/traducătorul nu a citit materialul: procentele română/spaniolă spun una, textul spune altceva! Vai de textele tale, Newaweek, vai și amar!